پروتکل MCP برای ارتباطات بین ایجنتها ممکن است خطرناکترین پروتکلی باشد که تاکنون اسمش را نشنیدهاید
شکافهای اعتماد در پروتکل جدید، پرامپتهای مخرب را از یک ایجنت به ایجنت دیگر منتقل میکنند.
به کارگیری ایجنتهای هوش مصنوعی در میلیونها سازمان، فرصتهای جدیدی را برای مهاجمان فراهم میکند تا آنها را وادار به انجام اقدامات مخربی مانند استخراج محتویات پایگاهداده و اطلاعات حساس تجاری و شخصی کنند.
طی پنج ماه گذشته، گوگل و چهار سازمان دیگر — که اشتراک چندانی با یکدیگر ندارند مگر در استفاده از ایجنتهای هوش مصنوعی — آسیبپذیریهایی را تأیید کردهاند که از یک ایجنت درون شبکه هدف سوءاستفاده میکنند تا دستورالعملهای مضری را به سایر ایجنتهای داخلی انتشار دهند. این تکنیک شکل خاصی از تزریق پرامپت (Prompt Injection) است که نه مدل زبانی بزرگ (LLM)، بلکه یک ایجنت خاص (مانند ایجنت ترجمه یا تحلیل داده) را هدف قرار میدهد. موانع امنیتی (Guardrails) درون اینگونه ایجنتها، اگر اصلا وجود داشته باشند، اغلب بسیار ضعیف هستند و دستورالعملها را به ایجنتهای بعدی در زنجیره ارسال میکنند. از آنجا که ایجنت دوم به طور صریح به ایجنت اول اعتماد دارد، از دستورات آن پیروی میکند.
غیرمنتظره و دشوار برای کاهش خطر
سید انس محیالدین، پژوهشگر مستقل، ایجنتهای متعلق به سازمانهایی از جمله گوگل، جیپی مورگان چیس، Weviate، Rapid7، اداره کل دیجیتال بینوزارتی دولت فرانسه و دولت فدرال ایالات متحده را آزمایش کرد. حملات اثبات مفهومی او از شکافهای اعتماد در MCP سوءاستفاده میکنند که مخفف Model Context Protocol (پروتکل زمینه مدل) است. این استاندارد یکی از راههایی است که برنامهها و ایجنتهای هوش مصنوعی از طریق آن در یک شبکه داخلی با یکدیگر ارتباط برقرار میکنند. تصویر زیر یک پروتکل MCP سادهشده را در حال کار نشان میدهد.
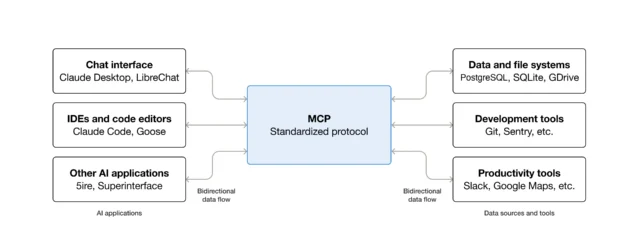
بسیاری از ایجنتهای تکمنظوره فاقد موانع امنیتی هستند که معمولاً میتوانند مخربترین پیامدهای تزریق پرامپت را کاهش دهند. و از آنجایی که سرورهای MCP اعتبارنامهها را برای هر ایجنت ذخیره میکنند — و ایجنتها به گونهای ساخته شدهاند که به هر ایجنت داخلی دیگری اعتماد کنند — یک آسیبپذیری که توسط مدل زبانی بزرگ رد میشد، در اینجا موفق عمل میکند. در بسیاری از موارد، پرامپتهای هوشمندانهای که ایجنت مناسب را هدف قرار میدهند، به جعل درخواست سمت سرور (SSRF) منجر میشوند؛ آسیبپذیریای که باعث میشود وبسرور درخواستهای شبکه غیرمجازی را ارسال کند.
داگلاس مککی، مدیر بخش اطلاعات آسیبپذیری در Rapid7، به وبسایت Ars گفت: «ایجنتهای هوش مصنوعی مجموعه تازهای از ارتباطات را در اختیار مهاجمان قرار میدهند تا از آنها عبور کنند. کسی متنی را در محتوایی قرار میدهد، یک ایجنت آن را میخواند و سپس به عنوان یک وظیفه تفویضشده عادی به ایجنت دیگری تحویل میدهد، و آن ایجنت دوم آن را اجرا میکند چون به کسی که کار را به او تحویل داده اعتماد دارد. تکتک اجزای این زنجیره دقیقاً همان کاری را انجام دادند که برای آن طراحی شده بودند، و همین موضوع تشخیص آن را بسیار دشوار میکند. هر پروتکل طوری ساخته شده که فرض میکند به صورت مستقل زندگی میکند، بنابراین هر کدام فقط جلوی در خانه خود را بررسی میکنند در حالی که هیچکس حواسش به راهرو میان آنها نیست.»
آسیبپذیری CVE-2026-97228 که سید در شبکه Rapid7 پیدا کرد، دارای امتیاز شدت تنها ۲.۷ از ۱۰ بود. شرکت Rapid7 ماه گذشته آن را برطرف کرد.
آسیبپذیریای که گوگل را تحت تأثیر قرار داد شدیدتر بود و امتیاز ۸ را داشت. این آسیبپذیری ناشی از آن بود که جعبهابزار MCP برای پایگاههای داده (googleapis/mcp-toolbox) کلاینت HTTP خود را بدون استفاده از سیاست CheckRedirect مقداردهی اولیه کرده بود؛ مجموعهای از تنظیمات که نحوه مدیریت مواردی را که یک URL یا خطایی برمیگرداند یا به URL دیگری هدایت میشود، کنترل میکنند. کلاینت HTTP گوگل همچنین در اعتبارسنجی آدرسهای IP هدف ناموفق بود.
سید توضیح داد: «یک پارامتر مسیر دستکاریشده میتواند باعث شود جعبهابزار، هدایت (Redirect) را به سمت یک نقطه پایانی داخلی دنبال کند و از طرف مهاجم درخواستهایی را ارسال کند.» اصلاحیه گوگل شامل اعمال یک فهرست مجاز (Allow-list) از محدودههای IP و فهرستهای مسدودسازی بود. «این اصلاحیه یک URL پایه ناامن را در هنگام راهاندازی رد میکند، نه در اولین درخواست. یک محافظ واقعی SSRF اینگونه است. این کار همچنین بیشتر از کاری است که اکثر سرورهای MCP انجام دادهاند.»
سید این دسته از حملات را «محور زدن پروتکل» (Protocol Pivoting) مینامد، زیرا این سوءاستفادهها زمانی کار میکنند که یک برنامه یا سرور از MCP برای اختصاص دادن وظیفهای به یک ایجنت استفاده کند و سپس آن ایجنت دستورالعملهای مخرب را با استفاده از روش ارتباطی دیگری (مانند پروتکل ایجنت به ایجنت گوگل یا A2A که برای تفویض کار بین ایجنتها استفاده میشود، یا استانداردهای نوظهوری مانند پروتکل شبکه ایجنت) به ایجنت دیگری فوروارد کند. به گفته او، اغلب اعتماد یا مجوز به طور موثری در این ترجمه گم میشود. او محور زدن پروتکل را به عنوان «یک حمله چندمرحلهای توصیف کرد که در آن یک مهاجم از طریق یک پروتکل به دسترسی اولیه میرسد، از فرضهای اعتماد میان پروتکلها سوءاستفاده میکند و به قابلیتهایی دسترسی پیدا میکند که تنها از طریق یک پروتکل متفاوت قابل دسترسی هستند.»
مارکوس ورویِر، پژوهشگر شرکت X41 D-Sec که او نیز حملات مبتنی بر هوش مصنوعی با سوءاستفاده از MCP را ابداع کرده است، گفت که اصطلاح بهتر همچنان «تزریق پرامپت» است و تکنیک سید زیرمجموعه سادهای از آن محسوب میشود.
او به Ars گفت: «از نظر من این یک تزریق پرامپت غیرمستقیم است. این واقعیت که پرامپت مخرب میتواند از یک پروتکل متفاوت (مثلاً A2A) سرچشمه بگیرد و هنگام استفاده از طریق پروتکل دیگری بروز پیدا کند، برای کارکردن چنین حملاتی کاملاً ضروری نیست. البته این موضوع در کل غیرمنتظره است و کاهش خطر آن دشوار است.»
این واقعیت که تکنیک محور زدن در پنج سازمان که هیچ اشتراکی جز استفاده از MCP با یکدیگر نداشتند کار کرده است، قابل توجه میباشد. پروتکل MCP جدید است و قبل از اینکه به اندازه کافی آزمایش و ایمنسازی شود، همهجا فراگیر شده است. سازمانها در عجله خود برای ساخت معماریهای گسترده مبتنی بر ایجنت، یک اصل کلیدی امنیتی به نام «اعتماد صفر» (Zero Trust) را کنار گذاشتهاند. تحت این مدل، شبکهها با این فرض ساخته میشوند که یک یا چند گره ممکن است آلوده شده باشند. برای کاهش اثرات این موضوع، مهندسان باید گرهها را به گونهای طراحی کنند که پیش از انجام تراکنشهای حساس با سایر گرهها، نیازمند احراز هویت باشند.
مککی گفت: «درسی که دوست دارم مردم از این موضوع بگیرند این است که هر چیزی که از یک مدل زبانی بزرگ به ابزار شما منتقل میشود باید مانند ورودیِ یک غریبه در اینترنت رفتار شود، زیرا در سناریوی تزریق پرامپت دقیقاً همینطور است. باگهای زیرساختی دوستان قدیمیای مانند تزریق (Injection) و SSRF هستند و راهحلهای آنها طی ۲۰ سال گذشته تغییر نکرده است. باید به این پژوهشگر اعتبار داد که نامی روی آن گذاشته است، زیرا نامگذاری همان چیزی است که مدافعان و نهادهای استانداردسازی را وادار میکند تا واقعاً برای مقابله با آن دست به طراحی بزنند.»
نظر مهندس بهمن آبادی: معماریهای چند ایجنتی به دلیل پیشفرض «اعتماد درونشبکهای» به شدت در برابر انتشار پرامپتهای مخرب از طریق MCP آسیبپذیرند. به عنوان یک توسعهدهنده، نباید به خروجی ایجنتهای همکار اعتماد مطلق داشت؛ بلکه پیادهسازی مدل «اعتماد صفر» و اعتبارسنجی دقیق ورودیها در تمام لبههای ارتباطی الزامی است. فراموش نکنیم که باگهای مدرن هوش مصنوعی اغلب پشت همان آسیبپذیریهای کلاسیک SSRF و تزریق پنهان شدهاند.